LLM이란? 챗GPT는 어떻게 답을 만들까
챗GPT는 정답을 찾아서 답하는 게 아니라, 다음에 올 말을 예측해서 이어 씁니다. 이 원리부터 알면 할루시네이션, 프롬프트, 검색 기능까지 한결 쉬워집니다.
AI라는 말이 붙지 않은 제품, 장소, 일을 하나라도 떠올릴 수 있나요?
광고는 에이전트를 100개씩 돌리라고 하고, 강의는 가장 비싼 모델을 쓰라고 합니다. 안 따라가면 나만 뒤처질 것 같습니다.
그런데 챗GPT도, Claude도, Gemini도 그 중심에는 LLM이 있습니다. LLM 하나만 제대로 이해해도 AI가 훨씬 덜 막막해지고, 훨씬 잘 쓸 수 있습니다.
LLM이란 무엇인가: 거대한 자동완성
휴대폰 자동완성을 떠올리면 됩니다
메시지를 쓰면 키보드 위에 다음 단어 후보가 뜹니다. 지금까지 쓴 글을 보고 다음 말을 추측하는 기능입니다.
LLM(Large Language Model, 대규모 언어 모델)도 같은 일을 합니다. 본질은 자동완성 장치입니다.
차이는 규모입니다. 키보드는 단어 하나를 추천하지만, LLM은 문단 여러 개, 토큰으로 치면 수천 개를 이어서 씁니다.
검색이 아니라 예측입니다
LLM은 어딘가에 저장된 정답을 꺼내 오지 않습니다. 고르는 기준은 「사실인가」가 아니라 「이 문맥 다음에 올 법한가」입니다.
그래서 그럴듯한데 틀린 답이 나올 수 있습니다. 뒤에서 볼 할루시네이션이 바로 이것입니다.
「요즘 챗GPT는 검색도 하던데요?」
맞습니다. 다만 검색은 LLM이 직접 하는 게 아니라, LLM에 붙은 도구가 합니다.
LLM은 학습을 끝낸 시점까지의 글로 만들어집니다. 그 이후에 생긴 일은 모릅니다. 이 시점을 지식 기준일(knowledge cutoff)이라고 합니다. 그래서 AI 서비스들은 LLM에 웹 검색 기능을 붙여서, 기준일 이후의 최신 정보로도 답할 수 있게 만듭니다.
흐름은 이렇습니다.
- 판단: 모델이 질문을 보고 검색이 필요한지 판단합니다. 대화 안에 답이 없고 검색으로 찾을 수 있는 질문이면 검색을 요청합니다.
- 실행: 실제로 검색을 하는 건 모델이 아니라 서비스입니다. 모델은 스스로 아무것도 실행하지 않습니다.
- 투입: 검색 결과가 모델이 읽는 「앞의 글」에 추가됩니다.
- 예측: 모델은 그 결과를 보고 다시 이어서 답을 씁니다. 답에는 출처 링크가 달립니다.
결국 마지막은 예측입니다. 질문과 관계없는 정보를 가져오면, 근거를 갖춘 답이라도 핵심을 벗어나거나 틀릴 수 있습니다.
심화: 문장 하나가 LLM 안에서 처리되는 과정
「오늘 날씨가 좋아서」 다음에 올 말을 LLM이 고른다고 해 보겠습니다. 이 짧은 순간에 안에서는 여섯 단계가 돌아갑니다.
1단계 · 토큰화: 글을 조각으로 자른다
토크나이저가 입력된 글을 토큰으로 자릅니다. 요즘 모델은 대부분 단어보다 작은 서브워드 단위로 자릅니다.
그래서 한 단어가 토큰 하나일 수도, 여러 개일 수도 있습니다. 영어 dogs는 dog와 s, 두 토큰으로 나뉠 수 있습니다.
2단계 · 임베딩: 토큰을 벡터로 바꾼다
모델은 글자를 그대로 계산하지 못합니다. 그래서 토큰마다 실수 여러 개로 이뤄진 숫자 목록, 곧 벡터로 바꿉니다. 이것을 임베딩이라고 합니다.
이 숫자들은 아무렇게나 정한 게 아니라 학습으로 정해집니다. 뜻의 관계가 벡터 공간 안의 구조로 담기도록 학습되고, 두 임베딩의 내적이 둘이 얼마나 비슷한지를 나타냅니다.
유명한 예가 있습니다. 예전 임베딩 방식인 word2vec에서도 cow(암소)에서 bull(황소)까지의 거리는 ewe(암양)에서 ram(숫양)까지의 거리와 비슷하게 나옵니다. 뜻의 관계가 숫자 사이의 거리로 바뀌는 것입니다.
한 가지가 더 붙습니다. 트랜스포머는 그 자체로는 단어의 순서를 모릅니다. 그래서 임베딩에 위치 인코딩(positional encoding)을 더해, 각 토큰이 몇 번째에 있는지 알려 줍니다.
3단계 · 어텐션: 토큰끼리 서로를 참고한다
이제 각 토큰이 문장 안의 다른 토큰을 얼마나 참고할지 정합니다. 이것이 셀프 어텐션입니다.
토큰마다 학습된 변환으로 세 가지 벡터를 만듭니다. 사전을 찾는 일에 빗대면 이렇습니다.
| 벡터 | 비유 | 역할 |
|---|---|---|
| 쿼리(Q) | 내가 찾는 것 | 이 토큰이 어떤 정보를 원하는지 |
| 키(K) | 각 항목의 꼬리표 | 다른 토큰이 어떤 정보를 가졌는지 |
| 값(V) | 항목의 실제 내용 | 참고할 때 실제로 가져가는 정보 |
계산은 이렇습니다. 쿼리와 모든 키의 내적을 구하고, 키 벡터 차원(dₖ)의 제곱근으로 나눈 뒤, 소프트맥스로 가중치를 만듭니다. 그 가중치로 값들을 더한 것이 결과입니다.
Attention(Q,K,V) = softmax(QKᵀ/√dₖ)·V글을 만들어 내는 쪽에서는 뒤에 올 토큰을 미리 보지 못하게 가립니다(마스킹). 그래서 각 자리의 예측은 그 앞에 있는 토큰에만 기댈 수 있습니다. 「다음 말 맞히기」가 성립하는 이유입니다.
이 계산은 한 번이 아니라 여러 번 나란히 합니다. 이것을 멀티헤드 어텐션이라고 하고, 헤드마다 서로 다른 관계를 잡아냅니다. 트랜스포머 원 논문은 8개의 헤드를 썼습니다.
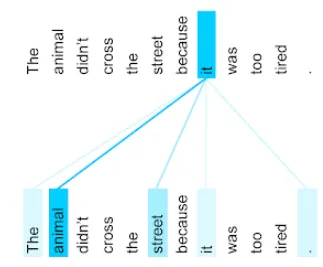
그림으로 보면 이렇습니다. 「The animal didn’t cross the street because it was too tired」에서 it이 어느 단어를 참고하는지 계산하면, animal과의 관련이 가장 크게 나옵니다. 문장 끝을 tired에서 wide로 바꾸면, 이번에는 street이 it과 더 관련 있다고 봐야 합니다. 같은 it인데도 문맥에 따라 해석이 달라집니다.
그림: Google Machine Learning Crash Course (CC BY 4.0)4단계 · 층을 쌓는다
어텐션과 피드포워드 신경망을 한 묶음으로, 같은 구조의 층을 여러 겹 쌓습니다. 트랜스포머 원 논문은 6개 층을 쌓았습니다.
층을 하나 지날 때마다 각 토큰의 벡터는 문장의 다른 토큰 정보를 섞어 새 벡터가 됩니다. 처음에는 「좋아서」라는 낱말 하나의 벡터였던 것이, 층을 지나며 「오늘 날씨가 좋아서」라는 문맥이 담긴 벡터로 바뀝니다.
5단계 · 다음 토큰의 확률을 계산한다
마지막 층을 지난 벡터를 선형 변환해서, 모델이 아는 모든 토큰마다 점수(로짓)를 매깁니다. 이 점수를 소프트맥스에 넣으면 합이 정확히 1이 되는 확률로 바뀝니다.
「산책」, 「기분이」, 「밖으로」 같은 후보마다 확률이 붙는 것이 바로 이 단계입니다.
6단계 · 하나를 고르고, 처음으로 돌아간다
확률표에서 다음 토큰을 하나 고릅니다. 가장 확률이 높은 것을 고를 수도 있고, 일정 확률을 넘는 후보 가운데서 무작위로 고를 수도 있습니다.
이 무작위의 정도를 정하는 값이 temperature입니다. 높을수록 답이 다양해지고, 낮을수록 일정해집니다. 같은 질문에 매번 조금씩 다른 답이 나오는 이유 중 하나가 이것입니다.
고른 토큰은 입력 끝에 붙고, 1단계부터 다시 돕니다. 자기가 앞에서 만든 토큰을 바탕으로 다음 토큰을 예측하는 방식을 자기회귀라고 하고, 트랜스포머 기반 LLM은 모두 이 방식입니다.
이렇게 한 번에 다룰 수 있는 토큰의 수에는 한계가 있습니다. 이것을 문맥 창(context window)이라고 하고, 창이 클수록 더 많은 정보를 참고해 답할 수 있습니다.
학습은 어떻게 하나
학습도 같은 방식입니다. 글의 앞부분을 보여 주고 바로 다음 토큰을 맞히게 합니다. GPT 원 논문도 앞의 토큰 몇 개를 보고 다음 토큰이 나올 확률을 최대로 만드는 것을 학습 목표로 삼았습니다. 틀린 정도는 손실(loss)로 계산하고, 역전파로 파라미터를 조금씩 고칩니다.
이것을 방대한 글로 반복하는 것이 사전 학습입니다. 사전 학습만 마친 모델은 그대로 쓰기 어려운 경우가 있어서, 파인튜닝이나 지시 튜닝(instruction tuning) 같은 추가 학습으로 다듬습니다.
한눈에 정리
| 용어 | 한 줄로 기억하기 | 정확히 |
|---|---|---|
| 토큰 | AI가 읽는 글자 조각 | 모델이 학습하고 예측하는 가장 작은 단위. 요즘은 대부분 서브워드 |
| 임베딩 | 뜻을 좌표로 바꾼 것 | 토큰을 학습된 실수 벡터로 바꾼 것. 두 벡터의 내적이 곧 유사도 |
| 위치 인코딩 | 몇 번째 단어인지 붙인 번호표 | 순서를 모르는 트랜스포머에 토큰 위치를 알려 주는 값 |
| 셀프 어텐션 | 단어끼리 서로를 참고한다 | Q·K 내적으로 가중치를 구해 V를 섞는 계산 |
| 파라미터 | 학습으로 조정된 손잡이 수천억 개 | 학습으로 정해지는 모델 안의 값. 트랜스포머는 수천억 개, 많게는 수조 개 |
| 소프트맥스 | 점수를 확률로 바꾸는 함수 | 모든 후보의 확률 합이 정확히 1이 되게 만든다 |
| temperature | 답의 모험 정도 | 높을수록 다양하고, 낮을수록 일정하다 |
| 문맥 창 | 한 번에 읽을 수 있는 분량 | 한 번에 처리할 수 있는 토큰 수 |
| 사전 학습 · 파인튜닝 | 먼저 많이 읽고, 그다음 직무 교육 | 방대한 글로 먼저 학습하고, 특정 작업의 예시로 더 학습시킨다 |
AI 활용 분야, 코딩보다 많은 건 설명과 문서
원리는 이만큼 깊지만, 쓰는 데 이걸 다 알아야 하는 건 아닙니다. AI는 생각보다 훨씬 가볍게 시작할 수 있습니다. 중요한 것은 남들이 무엇을 쓰는지가 아니라, 나에게 실제로 필요한 것이 무엇인지 찾는 일입니다.
AI를 개발자들의 도구라고 생각하기도 쉽습니다. 실제 사용 기록은 조금 다릅니다.
Claude를 만드는 Anthropic이 2026년 4월 10일부터 6월 10일까지 Claude 채팅과 Cowork 대화를 분석했습니다. 대화마다 무엇이 결과물로 나왔는지 나눠 보니 이랬습니다.
- 설명·안내 같은 대화형 결과물: 대화의 약 3분의 1
- 문서·발표 자료 같은 글 결과물: 약 3분의 1
- 앱·스크립트 같은 코드와 기술 작업: 약 6분의 1
하나씩 보면 가장 많은 결과물은 설명(17%), 문서와 보고서(15%), 안내(11%) 순이었습니다.
사람들은 이미 무언가를 이해하고, 글을 쓰고, 조언을 구하는 데 AI를 쓰고 있습니다. 코딩을 못 해도 AI를 쓸 이유는 충분합니다.
왜 내 AI는 남의 AI보다 멍청해 보일까
같은 AI를 써도 어떤 사람은 꽤 좋은 결과를 얻고, 어떤 사람은 엉뚱하거나 만족스럽지 않은 답을 받습니다.
이유는 여러 가지지만, 먼저 알아야 할 것은 하나입니다. AI는 항상 100% 정확하고 완벽한 답을 내놓는 시스템이 아닙니다.
할루시네이션: 그럴듯하게 틀리는 것
LLM의 예측에는 실수가 자주 섞입니다. 이것을 할루시네이션이라고 부릅니다. 학습한 방대한 글 안에 틀리거나 치우친 내용이 섞여 있을 수 있다는 것도 이유 중 하나입니다.
LLM은 정답을 찾는 게 아니라 이어질 말을 예측합니다. 그럴듯한 것과 맞는 것은 다른 일입니다.
이 빈틈을 메우려고 나온 방법이 프롬프트 엔지니어링, 스킬, RAG 같은 것들입니다. 이름은 어려워 보여도 막상 해 보면 어렵지 않습니다.
틀린 답을 줄이는 질문법 세 가지
Claude를 만든 Anthropic은 공식 문서에 할루시네이션을 줄이는 방법을 정리해 두었습니다. 그중 누구나 채팅창에서 바로 쓸 수 있는 것은 세 가지입니다.
- 「모른다」고 해도 된다고 허락하기. 질문 끝에 「확실하지 않으면 모른다고 답해 줘」를 붙입니다. 문서는 불확실함을 인정해도 된다고 분명히 허락하는 것만으로 틀린 정보를 크게 줄일 수 있다고 설명합니다.
- 근거 문장을 그대로 옮기게 하기. 긴 자료를 주고 물을 때는, 답하기 전에 관련 문장을 글자 그대로 먼저 뽑게 합니다. 답이 실제 글에 기대게 되어 할루시네이션이 줄어듭니다.
- 같은 질문을 여러 번 돌려 보기. 같은 질문으로 답을 몇 번 받아 비교합니다. 답끼리 서로 다르면 그 부분은 할루시네이션일 수 있다는 신호입니다.
다만 문서도 이 방법들이 할루시네이션을 크게 줄여 줄 뿐 완전히 없애지는 못한다고 적습니다. 중요한 정보는 직접 확인해야 합니다.
게다가 모델은 갈수록 좋아지고 있습니다. 말이 자연스러워질수록, 틀린 답도 더 그럴듯해진다고 생각합니다. 그래서 중요한 내용일수록 직접 확인해야 합니다.
AI는 만능이 아닙니다. 답을 그대로 믿고 쓰면 독이 되고, 초안으로 쓰고 확인하면 득이 됩니다.
당연한 얘기 같지만, 확인하는 습관이 잡히지 않으면 점점 AI를 그대로 믿게 되고, 틀린 줄도 모른 채 오류 속에 빠지게 됩니다.
프롬프트 엔지니어링: 원하는 결과를 구체적으로 말하기
프롬프트 엔지니어링은 질문과 지시를 잘 써서 원하는 답을 끌어내는 일입니다. 이때 모델 자체는 전혀 바뀌지 않습니다. 같은 모델인데도 어떻게 묻느냐에 따라 답이 달라지는 이유입니다.
거창하게 생각할 필요는 없다고 봅니다. 예를 들면 이런 차이입니다.
모호한 요청: 이 회의록 적당히 알아서 정리해 줘.
구체적인 요청: 이 회의록을 팀장님께 보낼 거야. 결정된 것과 각자 할 일을 담당자 이름과 함께 목록으로 정리해 줘. 아직 결정되지 않은 건 따로 표시해 줘.
두 번째 요청에는 누가 읽을지, 무엇을 담을지, 어떤 형태로 받을지가 들어 있습니다.
핵심은 내가 원하는 결과가 무엇인지 구체적으로 설명하고, 결과를 확인하면서 계속 고쳐 나가는 것입니다. 첫 답이 마음에 안 들면 거기서 끝내지 말고 이어서 고쳐 달라고 하면 됩니다.
스킬: 자주 하는 일을 한 번에 가르쳐 두기
프롬프트가 한 번 쓰고 마는 지시라면, 스킬(Skills)은 반복되는 업무 방식과 자료를 미리 묶어 둔 것입니다.
Claude의 경우 필요할 때 스킬을 알아서 불러옵니다. 대화마다 「우리 회사 보고서는 이 양식으로, 이 순서로」를 다시 설명하지 않아도 됩니다. 매번 같은 설명을 붙여 넣고 있다면 스킬로 만들 때가 된 것입니다.
RAG: 내 자료를 근거로 답하게 하기
RAG(Retrieval-Augmented Generation, 검색 증강 생성)는 검색이나 데이터베이스 같은 정보 검색 시스템과 LLM을 합친 방식입니다. 질문과 함께 관련 자료를 찾아 LLM에 넣어 주면 할루시네이션을 줄일 수 있습니다. 앞에서 본 검색 기능도 같은 원리입니다.
RAG도 반드시 개발을 해야만 쓸 수 있는 것은 아닙니다.
평소 구글 서비스를 많이 쓴다면 NotebookLM이 쉬운 예입니다. PDF, 웹사이트, 유튜브 영상, 구글 문서 같은 자료를 올리면 그 자료를 바탕으로 답하고, 어느 부분을 근거로 했는지 원문 인용까지 달아 줍니다. 코딩 한 줄 없이 RAG를 경험해 볼 수 있는 셈입니다.
참고로 2026년 10월 현재 Google 도움말에는 Gemini Notebook이라는 이름으로 올라와 있습니다.
자동화와 바이브 코딩, 꼭 해야 할까
「오늘도 AI로 쓰레기를 만들었다」
요즘 개발자들이나 AI를 적극적으로 쓰는 사람들과 이야기하다 보면, 농담처럼 「오늘도 AI로 쓰레기를 만들었다」는 말을 하곤 합니다.
AI를 쓰면 정말 무엇이든 빠르게 만들어 볼 수 있습니다. 하지만 만들어지는 것과 잘 만들어지는 것은 전혀 다른 이야기입니다.
겉보기에는 그럴듯한데 내용이나 완성도가 아쉬운 경우가 있습니다. 간단하게 만들면 될 것을 AI를 과하게 쓰다가 오히려 복잡해지고 시간이 더 걸리는 경우도 있습니다. 저 역시 이런 부분을 많이 체감하고 있습니다.
남들이 한다고 무조건 해야 하는 건 아닙니다
그래서 자동화나 바이브 코딩도 남들이 다 한다고 해서 무조건 해야 하는 것은 아니라고 생각합니다.
공부해 보고 경험해 보는 것은 좋습니다. 하지만 하던 일을 갑자기 모두 그만두고 바이브 코딩만으로 개발자가 되겠다고 생각한다면, 생각보다 훨씬 큰 어려움을 겪을 수 있습니다.
먼저 찾을 것: 내가 어디에 시간을 쓰고 있나
제가 추천하는 방법은 조금 뻔할 수 있습니다. 먼저 내 삶에서 AI가 실제로 도움이 될 일을 찾는 것입니다.
- 매일 뉴스에서 원하는 정보를 찾는 데 시간이 너무 걸린다면, AI로 필요한 뉴스만 정리하거나 특정 데이터를 모으는 방법을 만들어 볼 수 있습니다.
- 특정 사이트에서 정보를 확인하고 링크를 모으는 일을 반복한다면, 간단한 코딩이나 자동화로 직접 시스템을 만들어 볼 수 있습니다.
- 매번 비슷한 문서를 쓰거나 자료를 정리한다면, AI로 그 과정을 줄일 수 있습니다.
중요한 것은 「무조건 AI를 써야지」가 아니라 「내가 지금 무엇 때문에 시간을 쓰고 있지?」를 먼저 찾는 것입니다.
문제를 찾았다면 GPT에게 상담하듯 이야기해 보는 것도 좋은 방법입니다.
이런 일을 매주 반복하고 있는데 시간을 줄이고 싶다. 어떤 방법이 있을까?
이렇게 물으면서 하나씩 방법을 찾고, 필요한 부분부터 공부해도 전혀 늦지 않습니다. 오히려 이렇게 시작하는 편이, 남들이 좋다고 하는 기술을 무작정 따라가는 것보다 나에게 정말 필요한 시스템을 만드는 길이 될 수 있습니다.
AI 보안과 일자리, 걱정되는 것들
보안: 검증 없이 맡길 때 생기는 문제
AI를 쓰다 보면 개인정보나 API 키가 새어 나가는 보안 문제도 생길 수 있습니다.
웹 보안 표준을 만드는 OWASP도 LLM을 쓰는 서비스의 대표 위험 1, 2번으로 프롬프트 인젝션과 민감 정보 노출을 꼽았습니다.
이것이 AI를 빠르게 도입하는 과정의 과도기적인 문제인지, AI에게 너무 많은 것을 검증 없이 맡겨서 생기는 문제인지는 더 지켜봐야 합니다.
그래도 개인이 지킬 수 있는 것은 분명합니다. 저는 이 두 가지만큼은 꼭 지키는 게 좋다고 생각합니다.
- 민감한 정보는 붙여 넣지 않는다. 주민번호, 계좌, 비밀번호, API 키, 회사 기밀은 AI 대화창에 그대로 넣지 않습니다.
- 결과는 확인하고 쓴다. 특히 코드, 숫자, 법이나 돈이 걸린 내용은 그럴듯해 보여도 한 번 더 확인합니다. 앞에서 본 것처럼 LLM은 그럴듯하게 틀릴 수 있습니다.
일자리: 걱정은 실제로 있습니다
AI가 워낙 빠르게 발전하다 보니 「AI가 일자리를 모두 빼앗는 것 아니냐」는 걱정도 많습니다. 시장 상황이 좋지 않은 지금은 이 불안이 더 크게 느껴질 수밖에 없습니다.
실제로 AI를 쓰는 사람들도 같은 걱정을 합니다. Anthropic이 Claude 사용자 8만 1천 명을 인터뷰했을 때, 생산성은 크게 올랐다고 하면서도 일자리를 잃을까 걱정하는 답이 나왔습니다.
하지만 AI는 이미 우리 생활과 산업에 깊이 들어왔고, 이제 와서 되돌릴 수도 없습니다. 결국 우리가 할 수 있는 것은 변화를 이해하고, 적응하고, 최소한이라도 제대로 활용할 방법을 찾는 것이라고 생각합니다.
과하지 않게, 하지만 제대로
AI를 모른다고 당장 문제가 생기지는 않습니다. 다만 AI를 활용하는 사람과 그렇지 않은 사람 사이의 격차는 앞으로 지금보다 훨씬 커질 것이라고 생각합니다.
그렇다고 상위 1%의 AI 활용법을 따라갈 필요는 없습니다. 비싼 도구를 구독하고 수십 개의 에이전트를 돌리는 것보다, AI가 무엇인지 제대로 이해하고 기본적인 활용법부터 익히는 것이 더 중요합니다.
유행하는 기술을 무조건 따라가기보다, 내가 가진 문제를 해결하는 데 AI를 어떻게 쓸 수 있는지 찾아보는 것. 과하지 않게, 하지만 제대로 쓰는 것. 투머치AI는 앞으로 이런 관점으로 AI의 기본과 활용법, 빠르게 바뀌는 흐름을 하나씩 정리해 보려고 합니다.
출처
- Google for Developers, Machine Learning Crash Course: Large language models (그림 포함, CC BY 4.0)
- Google for Developers, Machine Learning Glossary (CC BY 4.0)
- Vaswani et al., Attention Is All You Need (2017)
- Radford et al., Improving Language Understanding by Generative Pre-Training (2018)
- Anthropic, Claude Docs: Web search tool
- Anthropic, Claude Docs: How tool use works
- Anthropic, Claude Docs: Reduce hallucinations
- Anthropic, Claude Docs: Agent Skills
- Google Cloud, What is Retrieval-Augmented Generation (RAG)?
- Gemini Notebook 도움말, Learn about Gemini Notebook
- Anthropic Economic Index report: Cadences (2026년 6월)
- OWASP, Top 10 for LLM Applications 2025